AI Visibility Analyse im B2B: Der Kanal ohne Reporting
Einkäufer*innen und Entscheider*innen recherchieren ihre Anbieter auch im B2B längst in ChatGPT, Claude oder DeepSeek und kommen bereits mit einer Marken-Vorauswahl ins Gespräch. Wo früher das Keyword-Ranking bei Google mitentschied, kommt heute die Sichtbarkeit in KI-Sprachmodellen als immer wichtigerer Faktor hinzu. Aber was genau heißt eigentlich KI-Sichtbarkeit und warum sollte sie gerade im B2B nicht eine einzelne Zahl sein?
Tilman Bohn, effective GmbH
Senior Strategist
Tilman Bohn ist Director Technology bei der effective GmbH, und damit unter anderem für den Einsatz von KI im Unternehmen sowie die Entwicklung von in-house KI-Tools federführend verantwortlich. Die Agentur mit Sitz in Mannheim ist spezialisiert auf B2B-Industriekommunikation, von SEO, Content-Strategie und Website-Entwicklung bis zur Messung von Markensichtbarkeit in KI. Sie begleitet exportorientierte Mittelständler und Konzerne in Europa, Amerika und in China. Seit 2015 ist effective Mitglied im bvik.
Bildquelle: effective GmbH, Mannheim
Inhaltsverzeichnis
Sichtbarkeit messen heißt differenzieren
Die AI Visibility von Industrieunternehmen lässt sich nicht pauschal quantifizieren. Das liegt schon an den häufig technisch komplexen Produkten. Hinzu kommen markt- und industriespezifische Eigenheiten. Der Wettbewerber im einen Land ist anderswo Vertriebspartner, die Anbieterlandschaft kann von Region zu Region grundlegend variieren, verschiedene Zielindustrien haben unterschiedliche Gewichtungen der Produkteigenschaften.
Das zeigt sich auch in der KI-Sichtbarkeit. Ein Hersteller mag bei einer spezifischen Industrieanwendung als Goldstandard genannt werden, aber in einer eng verwandten Nische völlig fehlen. Er kann im DACH-Raum gut positioniert sein und in Frankreich oder den USA gar nicht vorkommen. Selbst innerhalb einer Sprache ist das Bild unter Umständen uneinheitlich: auf Spanisch in Mexiko sichtbar, in Spanien deutlich weniger; auf Englisch in Großbritannien präsent, in Indien unter dem Radar. Und je nach Buyer Persona oder Suchintention antwortet dasselbe Modell möglicherweise unterschiedlich.
Für die zitierten Quellen gilt dies noch deutlicher. Bei einem Unternehmen ohne spanischsprachige Website fanden wir einen Sichtbarkeitsscore für spanische Fragen nur knapp unter dem Wert für dieselbe Marke in Sprachen, die auf der Website verfügbar waren. Die Quellenzitate (Citations) gingen hingegen gegen Null. Dies ist durchaus plausibel: LLMs sind zwar in der Lage, ihre Antwort-Texte in nahezu beliebiger Benutzersprache zu präsentieren. Sie verlinken aber im Allgemeinen keine Quellenangaben in für die Benutzer*innen fremden Sprachen. Weder Google AI Overviews noch Gemini, Perplexity oder ChatGPT zitieren in unserer Erfahrung regelmäßig englische oder deutsche Inhalte, wenn die Frage auf Spanisch gestellt wurde.
Die Frage „Sind wir in der KI sichtbar?“ zerfällt im B2B damit in zahlreiche Einzelaspekte, und das umso mehr bei starker Exportorientierung. Wer sie mit einer flüchtigen Momentaufnahme aus ein paar Prompts beantwortet, bekommt kein strategisches Gesamtbild. Das Risiko ist groß, sich auf einer solch grobkörnigen Basis entweder in falscher Sicherheit zu wiegen oder sich umgekehrt zu wenig konstruktivem Aktionismus verleiten zu lassen.
Brand- und Non-Brand-Fragen erfordern unterschiedliche Auswertungen
Fragen an die KI können neutral ohne Markennennung gestellt werden oder bereits auf eine konkrete Marke abzielen – sei es auf ein Unternehmen, ein Produkt oder eine unter eigenem Markennamen vermarktete Technologie. Hier gilt es, bereits beim Scoring unterschiedliche Maßstäbe anzulegen. Im einen Fall ist ein wesentliches Merkmal guter Sichtbarkeit, dass die eigene Marke spontan erscheint oder die eigene Website zitiert wird. Im anderen hingegen ist das keine Überraschung: Wenn bereits nach „Firma/Produkt/Technologie X“ gefragt wurde, ist eine Erwähnung der Marke „X“ in der Antwort zu erwarten und kein starkes Scoring-Kriterium. Hier ist vielmehr die Art der Darstellung relevant, wie etwa Tonalität, Erwähnung von soft USPs, Übereinstimmung mit oder Abweichung von der Eigendarstellung oder unvermittelte Erwähnung des Wettbewerbs. Um ein vollständiges und präzises Bild zu gewinnen, müssen beide Arten von Fragen abgedeckt, aber ganz unterschiedlich bewertet werden. Zudem möchte man nicht nur wissen, wie sich die eigene Marke dabei schlägt, sondern auch, wie die Wettbewerber im direkten Vergleich dastehen.
Verzerrte Marktbilder: Sichtbarkeit ist kein Marktanteil
Ähnlich wie beim SEO-Ranking spiegeln KI-Antworten die tatsächlichen Marktverhältnisse nur eingeschränkt wider. Es tauchen regelmäßig Marken auf, die man nicht auf der eigenen Wettbewerbsliste stehen hatte. Die Präsenz, Beschaffenheit und Zugänglichkeit öffentlich verfügbarer Informationen beeinflussen, was Sprachmodelle über Unternehmen wissen bzw. in Antworten verwenden können. Marktanteil und Bekanntheit fließen hier nur indirekt ein.
Was sich hingegen sehr direkt auswirkt: Wenn der etablierte Marktführer sein Fachwissen hinter Login-Schranken, Kontaktformularen oder vagen Marketingfloskeln versteckt, ist es für ein Sprachmodell schwer zu verarbeiten. Stellt ein aufstrebendes Startup seine Website mit Fachartikeln und Produktdaten dagegen sauber strukturiert, maschinenlesbar und frei zugänglich bereit, greifen die Modelle bei passenden Fragen viel eher darauf zurück. Der kleinere Anbieter erscheint dann möglicherweise prominent in der KI-Antwort, während der Branchenprimus fehlt. Für Marketingverantwortliche mag das wie eine unerklärliche Bevorzugung wirken, ist aber nur eine logische Folge von Struktur und Zugänglichkeit.
Schattenwettbewerber fallen im klassischen Marktmonitoring durch das Raster, weil sie nach Umsatz, Marktanteil oder Messepräsenz vermeintlich keine Rolle spielen. Wer die eigene Wettbewerbslandschaft nur aus dem Vertrieb oder aus klassischen Marktanalysen kennt, bemerkt eine Verschiebung möglicherweise unnötig spät. In einer genügend detailliert durchgeführten KI-Sichtbarkeitsanalyse kann sie dagegen sehr frühzeitig erkennbar werden.
Spezialfall China birgt zusätzliche Herausforderungen
Ähnlich wie bereits im allgemeinen Online-/SEO/App-Bereich hat China auch bei der KI ein weitgehend eigenständiges Ökosystem von Anbietern und Sprachmodellen, mit nur geringer direkter Überlappung mit den Angeboten in der westlichen Welt. Das Verhalten der Benutzer*innen unterscheidet sich grundlegend, mit viel größerem Gewicht auf der Verwendung der mobilen Apps der Anbieter und starker Integration mit deren anderen Services. Um die KI-Sichtbarkeit dort zuverlässig zu messen, muss man zum einen die relevanten Sprachmodelle z.B. von ByteDance (derzeit Marktführer), Tencent, Baidu oder Alibaba unterstützen. Zum anderen muss man Sondierungsfragen erstellen können, die den tatsächlichen Sprachgebrauch der Benutzer*innen reflektieren. Wir sehen in realen Messungen teils dramatische Unterschiede in der gemessenen Sichtbarkeit bei Fragen, die von westlichen Modellen erstellt wurden, im Vergleich zu „nativ“ von chinesischen Modellen generierten Fragenkatalogen.
Wie eine belastbare Messung aussieht
Es ist also unerlässlich, die Sichtbarkeit entlang zahlreicher Dimensionen zu differenzieren. Zielindustrien, Produkte, Anwendungen, Märkte etc.: Fragen müssen diesen klar zugeordnet und die kompletten Fragenkataloge versioniert sein, um sie jederzeit identisch wiederholen zu können. Ebenso ist zu gewährleisten, dass die gleichen Fragen in diversen relevanten Modellen (ggf. auch geographisch differenziert) durchgespielt werden. Statistisch tragfähig wird die Messung erst mit genügend Fragen und Antworten für jeden Dimensionswert. In unserer Erfahrung sind um die 20 Fragen oder mehr pro konkretem Dimensionswert (also pro Branche, Anwendung usw.) erstrebenswert, was bei einem breiten Portfolio schnell in den vierstelligen Bereich von Sondierungsfragen führt.
Warum wir dafür ein eigenes Werkzeug gebaut haben
Als wir vor über zwei Jahren begannen, AI Visibility für Industriekunden zu messen, erfüllten die am Markt verfügbaren Tools die beschriebenen Anforderungen nur teilweise, und nicht in der Art und Weise wie nach unserem Dafürhalten im B2B-Bereich notwendig. Konkret fehlte uns die Kombination aller folgenden Eigenschaften:
- Trennung der Messung nach Markt, Industrie und Anwendungsfall, kundenspezifisch feinkörnig separat konfigurierbar
- Analysen im Umfang von 1.000 und mehr Sondierungsfragen
- Erkennen von Schattenwettbewerbern außerhalb der hinterlegten Liste
- Abdeckung aller relevanten Sprachen
- Geographische Differenzierung (sofern von Modell/Suchmaschine unterstützt)
- Einbeziehung chinesischer Sprachmodelle
- Exakte Wahl der Modellversion innerhalb einer Modellfamilie
Mit effective aiva haben wir daher ein internes Werkzeug entwickelt, das passgenau die Fragestellungen unterstützt, die sich in unseren Kundenprojekten ergaben.
Vier Schritte zu einer strategischen AI Visibility Analyse
Ein systematisches Audit gliedert sich im Prinzip in die folgenden Schritte:
- Dimensionen und Wettbewerb definieren. Industrie, Produkte, Anwendungen, Intents beziehungsweise Personas und Themen oder USPs definieren den Suchraum, in dem die Sichtbarkeit gemessen werden soll. Ebenso ist zu entscheiden, welche Wettbewerber pro Markt relevant sind.
- Fragen zusammenstellen. Was fragen Einkäufer*innen und Entscheider*innen in den jeweiligen Märkten tatsächlich? Sinnvoll ist eine Mischung aus CRM-Anfragen, Vertriebswissen, Marketing- und Brand-Fragen sowie KI-generierten Fragen, die die Lücken schließen.
- Konfiguration festschreiben und messen. Fragen, Marken, Sprachen, Märkte und Modellversionen werden fixiert und dokumentiert. Erst diese Festlegung macht spätere Wiederholungsmessungen vergleichbar.
- Auswerten und ableiten. Ergebnisse aus dem aiva-Lauf sind zunächst Rohdaten, die nun einer ausgiebigen Auswertung unterzogen werden: Citation-Analyse nach Medien- und PR-Landschaft, Content-Typen, präferierte Modelle, Antwortmuster und Wettbewerbsanalysen einschließlich der Anbieter, die nicht auf der Liste standen. Das Endergebnis sind konkrete und spezifische Handlungsempfehlungen. Dafür ist der Gesamtscore nur sehr untergeordnet relevant, die Differenzierung nach Dimensionen ist hier essenziell.
Arbeitsteilung im Audit: Menschliche Intelligenz am Steuer, KI wertet aus
Ausgewertet wird mehrstufig. Zunächst der Grundscore pro Antwort: Wird die Marke genannt? An welcher Position? Welche Quellen zitiert das Modell? Dieser erste Schritt der Bewertung kann bei Tausenden Frage-Antwort-Paaren realistischerweise nur von der KI erledigt werden, die dabei in unserer Erfahrung überaus zuverlässig arbeitet.
Aber spannend wird es erst bei darauf aufsetzenden übergreifenden Fragestellungen. Aggregierte Werte, aber differenziert nach Dimensionen: Gibt es auffällig positiv oder negativ herausstechende Industrien, Produkte, Anwendungen? Fällt man gegenüber dem Wettbewerb gerade in bestimmten Phasen des Funnels ab oder hat dort Stärken? Welche Schattenwettbewerber erscheinen eventuell, die man nicht auf dem Schirm hatte, und in welchen Branchen? Greift die KI soft USPs wie „made in Germany“ oder „traditionsreiches Familienunternehmen“ in der Weise auf, wie man sie in der eigenen Außendarstellung sorgfältig betont? Gibt es weitere interessante Signale in den Nicht-Wettbewerber-Zitaten? Wir haben noch kein Projekt ohne Überraschungen in dieser Analysephase erlebt.
Auch wenn Teile der weitergehenden Auswertung KI-unterstützt ablaufen, gilt weiterhin: Für eine korrekte Einordnung der Ergebnisse in die Markt- und Wettbewerbssituation und die größeren strategischen Zusammenhänge ist nach wie vor menschliche Intelligenz unerlässlich.
Konkrete Handlungsempfehlungen werden erst durch eine solche feingliedrige Auswertung ermöglicht. Das macht den Unterschied zwischen allgemeingültigen Empfehlungen, die man auch jederzeit ohne vorherige Analyse geben könnte, und datenbasierten, zielgenauen Detailmaßnahmen, deren Erfolg hinterher im identischen Follow-up-Check messbar ist. Nur über diesen reproduzierbaren Prozess lässt sich nachvollziehen, welche Veränderungen nach den ergriffenen Maßnahmen eingetreten sind.
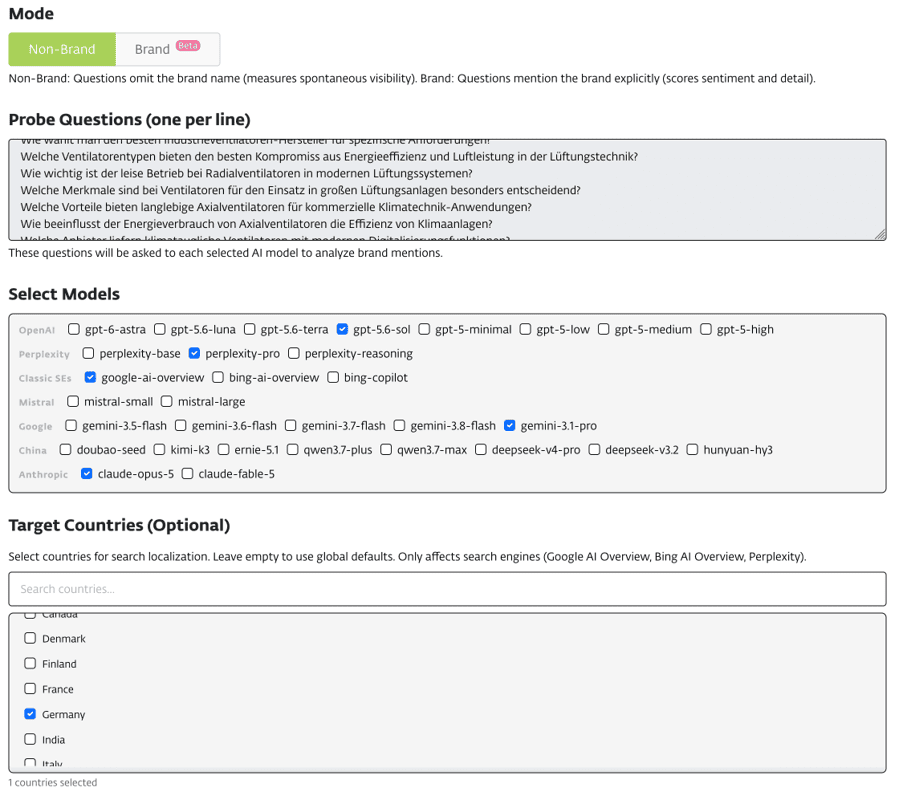
Abb. 1: Kleiner Ausschnitt der Konfiguration einer Messung: Trennung nach Brand und Non-Brand, hinterlegte Fragen und Auswahl der exakten Modellversionen und optional der Zielländer (Quelle: effective GmbH / aiva)
Was das für das B2B-Marketing heißt
AI Visibility ist keine Kennzahl, sondern ein Prozess. Entscheidend ist ein umfassendes Messsystem, dessen Wert damit steht und fällt, ob es die Märkte, Sprachen und Modelle abbildet, in denen tatsächlich eingekauft wird, und ob es genügend feinkörnig differenziert. Ebenso entscheidend ist, ob sich die Messung in sechs Monaten identisch wiederholen lässt.
Der Einstieg ist bei all dieser Komplexität jedoch schlanker möglich, als man denken mag: Ein Markt, eine Sprache, eine zunächst reduzierte Zahl an Dimensionen, Wettbewerbern und Sondierungsfragen, gemessen gegen die gängigsten Modelle.
Das Ergebnis entspricht auch hier bereits selten den Erwartungen. Genau darin liegt sein Wert.